大家好,我是大志。
在上一篇文章中,我们介绍了 Model 组件的用法。但光靠 Model 组件是无法完成推理、工具调用、问题回答等任务的,用户的问题、系统提示词、模型的回答以及工具的执行结果,都需要通过 Message 组件 进行封装和传递。
本文将系统介绍 LangChain V1.x 中 Message 组件的消息类型、内容结构以及常用操作。
另外,完整的 LangChain V1.0 教程 文档也已经同步到了 aiflowline.cn,大家可以结合本文一起阅读。
一、什么是 Message 组件
在 LangChain 中,Message 组件是整个框架的核心数据结构之一,也是对话上下文的载体。所有的 用户输入、大模型输出 和 工具调用结果 最终都会被封装成 Message 对象进行传递,它也是 Memory 组件和 LangGraph 状态管理的基础。
二、消息的类型
LangChain 中将消息分为四种类型:
HumanMessage:用户输入的内容。对于支持多模态的 LLM,可以包含文本、图像、音频等形式的内容。
SystemMessage:系统提示词,可以定义角色、设定模型行为,为 LLM 提供上下文。
AIMessage:LLM 生成的响应内容,包括文本内容、工具调用信息和元数据信息。
ToolMessage:工具调用的结果。
代码示例如下:
from datetime import datetime

import dotenv
from langchain.chat_models import init_chat_model
from langchain.messages import HumanMessage, SystemMessage
from langchain.tools import tool

dotenv.load_dotenv()


# 1. 定义工具及对应的 map
@tool
def get_current_time():
    """获取当前时间"""
    return datetime.now().strftime('%Y-%m-%d %H:%M:%S')


tools_map = {
    "get_current_time": get_current_time
}

# 2. 创建 model 对象
model = init_chat_model(
    "deepseek-v4-flash"
)

# 3. 定义消息列表
human_message = HumanMessage("你好,你是谁?现在什么时间?")
system_message = SystemMessage("你是一个知识问答机器人,你叫老K")
message_list = [human_message, system_message]

# 4. 绑定工具
bind_tool_model = model.bind_tools([get_current_time])

# 5. 调用 LLM 模型
ai_message = bind_tool_model.invoke(message_list)
message_list.append(ai_message)

# 6. 判断是否有函数调用
if ai_message.tool_calls:
    tool_message = tools_map.get((ai_message.tool_calls[0].get("name"))).invoke(ai_message.tool_calls[0])
    # 7. 将工具调用结果 ToolMessage 添加到消息列表
    message_list.append(tool_message)

# 8. 再次调用 model
ai_message = bind_tool_model.invoke(message_list)

print(ai_message.content)
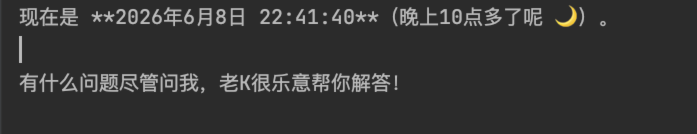
执行结果如下:
三、消息内容
3.1 content 字段
在 LangChain 的消息类中,使用 content 属性保存消息所承载的内容。不过,content 是一个弱类型属性,可以用来保存字符串、对象列表等形式的信息。对于 AIMessage 类来说,content 中保存的是模型返回的原始内容。
现在许多 LLM 支持多模态。除了直接传递文本消息之外,我们还可以通过 content 传递图片消息:
# 传递字符串
human_message = HumanMessage("你好,你是谁?")

# 通过 content 传递多模态信息
human_message = HumanMessage(content=[
    {"type": "text", "text": "这张图片是哪个动漫人物?"},
    {"type": "image", "url": "https://image.baidu.com/a.jpg"}
])
3.2 content_blocks 字段
在 LangChain v1.0 中,除了 content 能保存消息内容外,还提供了统一不同模型提供商数据格式的 content_blocks 字段。它的作用是屏蔽不同 LLM 厂商在传入和返回数据格式方面的差异,并统一消息内容的返回格式,让使用者不必再针对不同模型编写兼容逻辑。这些内容 LangChain 已经在内部完成封装。
在没有 content_blocks 之前,可能 OpenAI 返回这样的格式:
{
    "type":"reasoning",
    "summary":"..."
}
而 Anthropic 返回这样的格式:
{
    "type":"thinking",
    "thinking":"..."
}
每个厂商都有自己的格式,我们就需要编写大量的判断逻辑:
if openai:
    ...
if anthropic:
    ...
if gemini:
    ...
而现在通过 content_blocks 就可以获取统一格式的信息:
[
    {
        "type":"reasoning",
        "reasoning":"..."
    }
]
例如,可以在 HumanMessage 中使用 content_blocks 填充多模态信息:
# 通过 content_blocks 传递多模态信息
human_message = HumanMessage(content_blocks=[
    {"type": "text", "text": "这张图片是哪个动漫人物?"},
    {"type": "image", "url": "https://image.baidu.com/a.jpg"}
])
四、总结
在 LangChain 中,Message 组件用于保存对话消息。content 字段用于保存模型原始输入或输出内容,可能是字符串,也可能是 Provider 原生格式的数据结构。
content_blocks 是 LangChain 提供的标准化消息内容字段,用于以统一格式访问消息内容。
由于 AIMessage 表示 LLM 的输出结果,因此 content_blocks 中通常会包含更丰富的内容类型,例如文本(text)、推理过程(reasoning)、工具调用(tool_call)、引用(citation)以及多模态等内容。
好啦,本期 LangChain V1.0 教程就到这里。后面我会每周至少更新 1 期全新 LangChain V1 系列教程,想看后续内容的朋友,欢迎关注「大志说编程」!
觉得有用的话,转发给想要学习 AI Agent 的小伙伴,咱们下期见~